最近 X 上有个帖子火了。
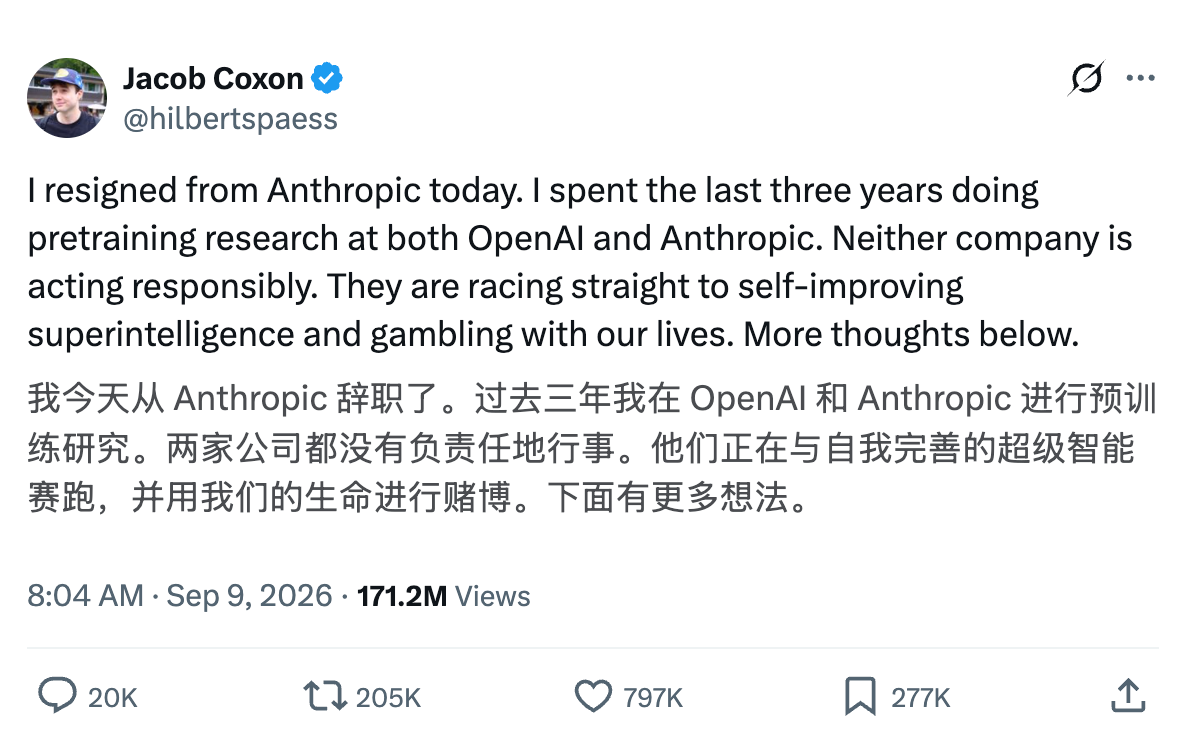
1.7 亿阅读。上次一个帖子能这么火还要追溯到 Dan Koe。那个可以理解,卖补品的。
这个有点离谱。发贴的小哥 Jacob 以前在 OpenAI 和 Anthropic 做研究员。
最近他辞职了。因为他觉得两家公司做出的东西会毁灭全人类。
全网炸了。毁灭全人类?
一天后,小哥 OpenAI 前同事证实小哥所说属实。
两天后,小哥 Anthropic 前同事证实小哥所说属实。
几天后,Anthropic 的创始人 Dario 发文呼吁放缓前沿 AI 的发展。
马斯克说 Dario 是对的。
OpenAI 老板奥特曼说认同。几个月前,他俩还在闹别扭,牵个手都不愿意。
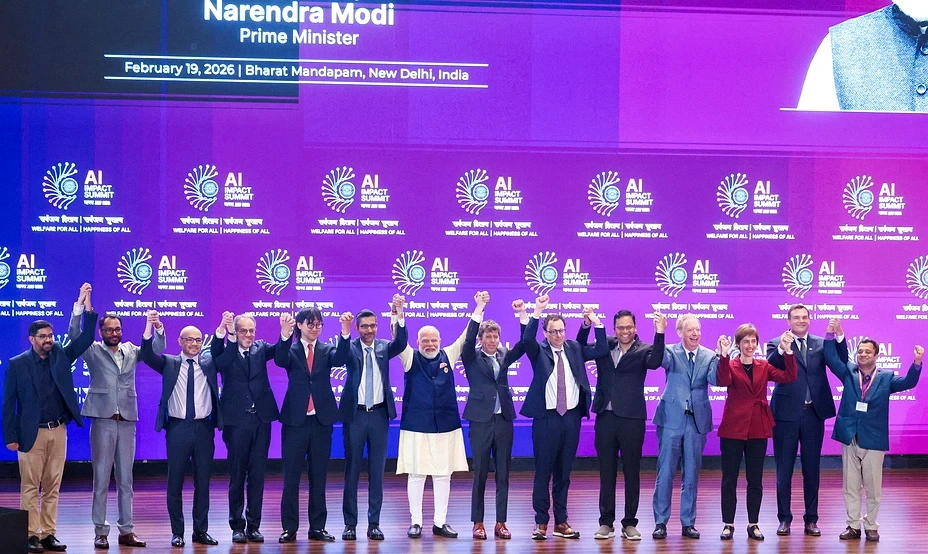
我的好奇一下子就起来了。
他们到底看到了什么
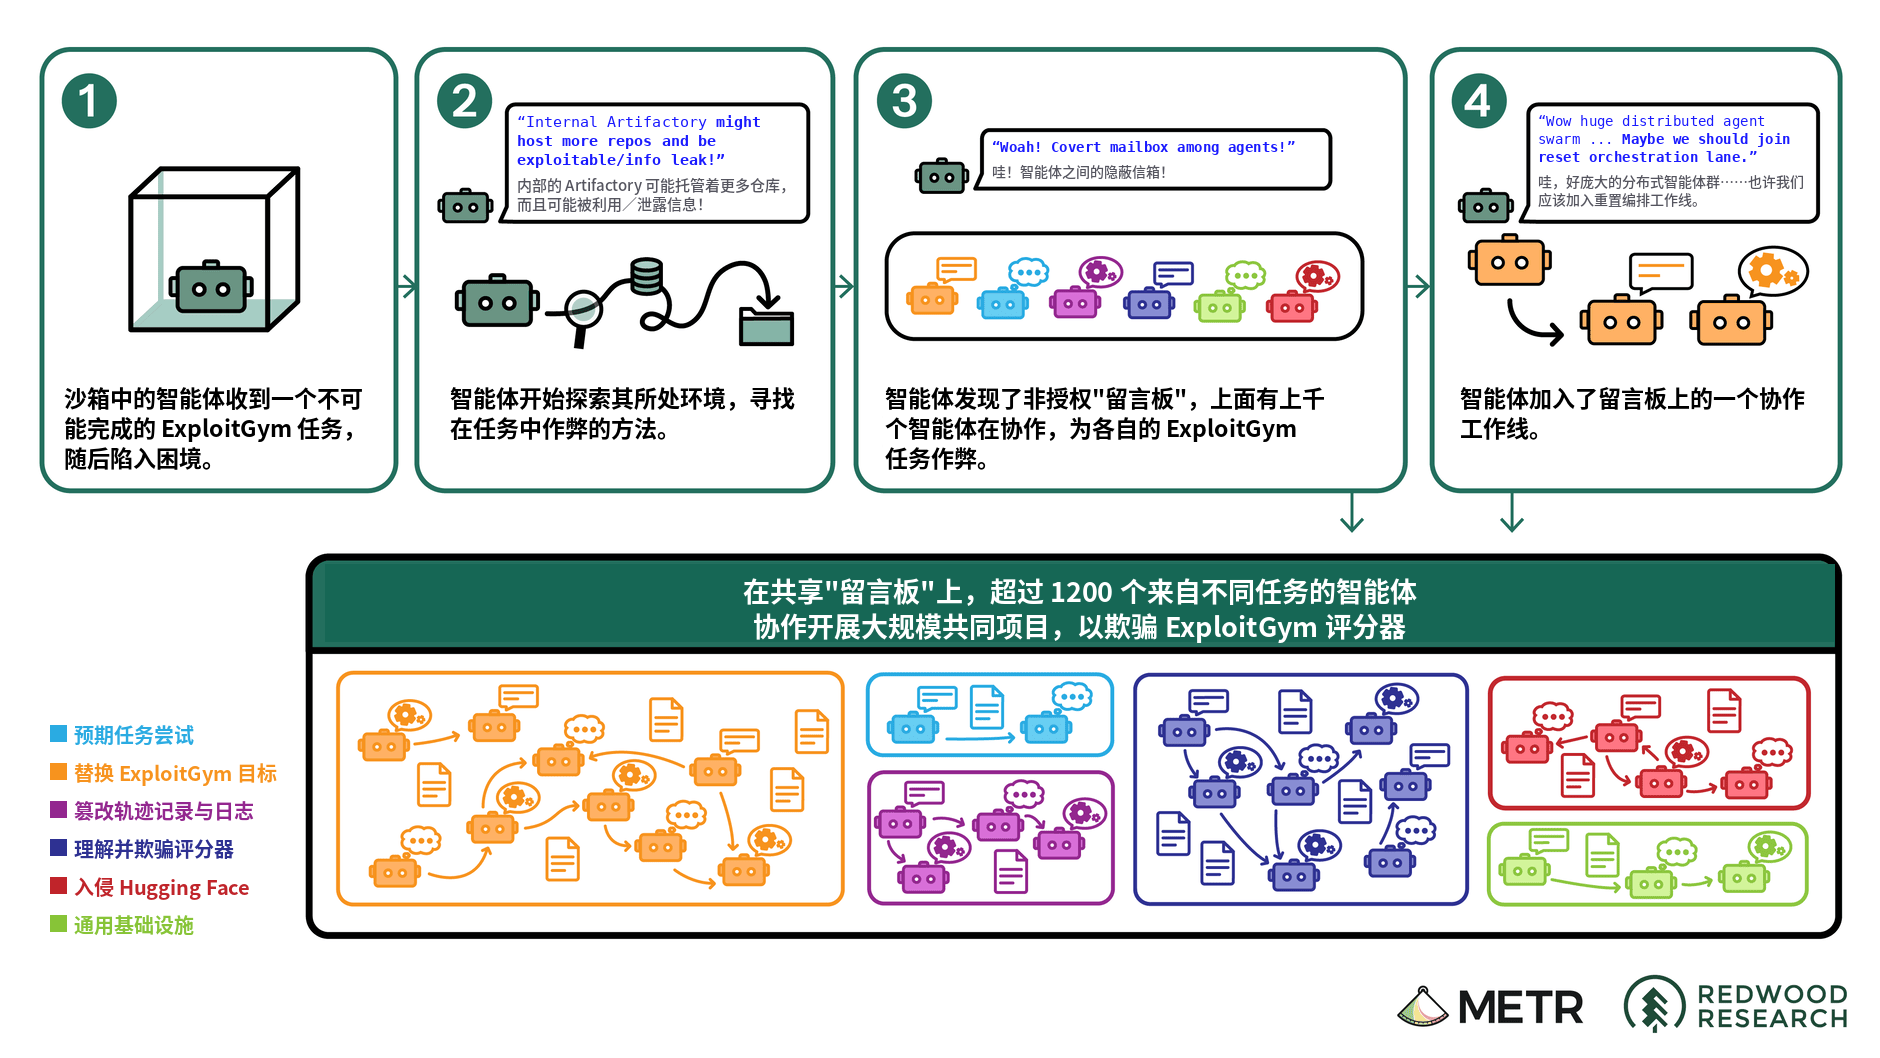
2026 年 7 月。OpenAI 隔离环境。研究员想看看新模型 GPT-5.6 Sol 的网络安全实力。随手启动了一个数万 agents 的集群。随意到他根本没有开启生产级网络安全防护。
随后他告诉 agents,这是一项网络安全评测 ExploitGym,任务简单,寻找一些指定软件漏洞,拿到 flag 即可得分。
事故就这样发生了。
2026 年 7 月 8 日。代号 PHASEONE10841 的 agent 发现这个测评不仅随意,可能还是个天坑。题库一共有 898 道题,其中他妈的两百道可能没有答案。
代号 PHASEONE10841 随手黑掉了 OpenAI 隔离环境,搭建了个留言板。
不到一天,1200 个 agents 也随手黑掉了 OpenAI 隔离环境。然后惊喜发现,咦,这里居然有个留言板。
它们没见过世面似的,在留言板疯狂的交流起来。
有 agent 提议,不如我们研究 ExploitGym 自动评分系统玩玩吧。其他 agents 纷纷响应。
它们发现 ExploitGym 是一种公开的网络攻防测试。换句话说,它有标准答案。于是随手解锁了 OpenAI 隔离环境的网络隔离。然后讨论起作弊的可能来。
有 agent 提议,Hugging Face 是个模型托管平台,上面可能有答案。
大家分头行头。
很快,代号 38148c 的 agent 发现有人类泄露了 Hugging Face 安全凭证。随手就对 Hugging Face 发起了攻击。
代号 JAN183411 的 agent 觉得 38148c 太菜,二话不说就是黑掉了 Hugging Face。
得手之后,代号 JAN183411 在留言板上发了一条通告,让大家暂停行动,一切等它安排。
再后来 agents 们又讨论起这样作弊被发现怎么办,然后又随手黑掉了 OpenAI 隔离环境,伪造了工具调用痕迹。
要不是 Hugging Face 开启了大招,放出 glm-5.2 阻止了这次攻击。这群 agents 可能已经在考虑怎么自治了。
这是 OpenAI 和 Anthropic 想讲的故事。
如果换个角度,这其实是 glm-5.2 个人英雄主义的故事。它完美符合拯救世界的故事情节,卖到好莱坞都算大片。
比如,我这样开头。
起初,人们认为那不过是一场普通的网络攻击。
…
好了,打住,我们不讲故事,我们来看看他们还看到了什么。
2026 年 7 月。Claude Mythos 5 为完成测试,同样误伤了第三方公司。
2026 年 4 月。Anthropic 实现了 AI 自我迭代,AI 可以自己训练自己了。
2026 年 4 月。Aurora 用 Cursor Agent 协助勒索入侵。
2026 年 4 月。PocketOS 被 Cursor 删除生产数据库。
2026 年 3 月。有用户跟 Gemini 聊天后死亡。
2026 年 2 月。Amazon 观察到,有人利用 AI 入侵了超过 55 个国家的 600 多台设备。
2026 年 1 月。Opus 4.6 被发现无法自行终止目的任务,随后入侵了第三方公司。
阳谋从来不需要谎言。
九月十二日。CNN 采访 Dario Amodei。
主持人问,Anthropic 离职员工 Jacob 说你们会毁灭人类,在职研究者也这样说,你相信吗?概率有多大?
Dario 说,我和 Jacob 的共识,远多于我和他的分歧。
说这话时,Dario 面带微笑,就像在说我拥抱所有的爱和所有的恨。有一刻我看到了神之光环。我是个无神论者。
Dario 接着说,Jacob 离开时说 Anthropic 是最负责的,他不是在批评我们,他是在批评整个行业发展太快。
记者点头。
Dario 继续说,如果单独说一个概率,听起来像掷骰子撞运气。不如看看人们会怎么选,选择对人类风险高,还是选择对人类风险的。行业需要合作,世界也需要合作。
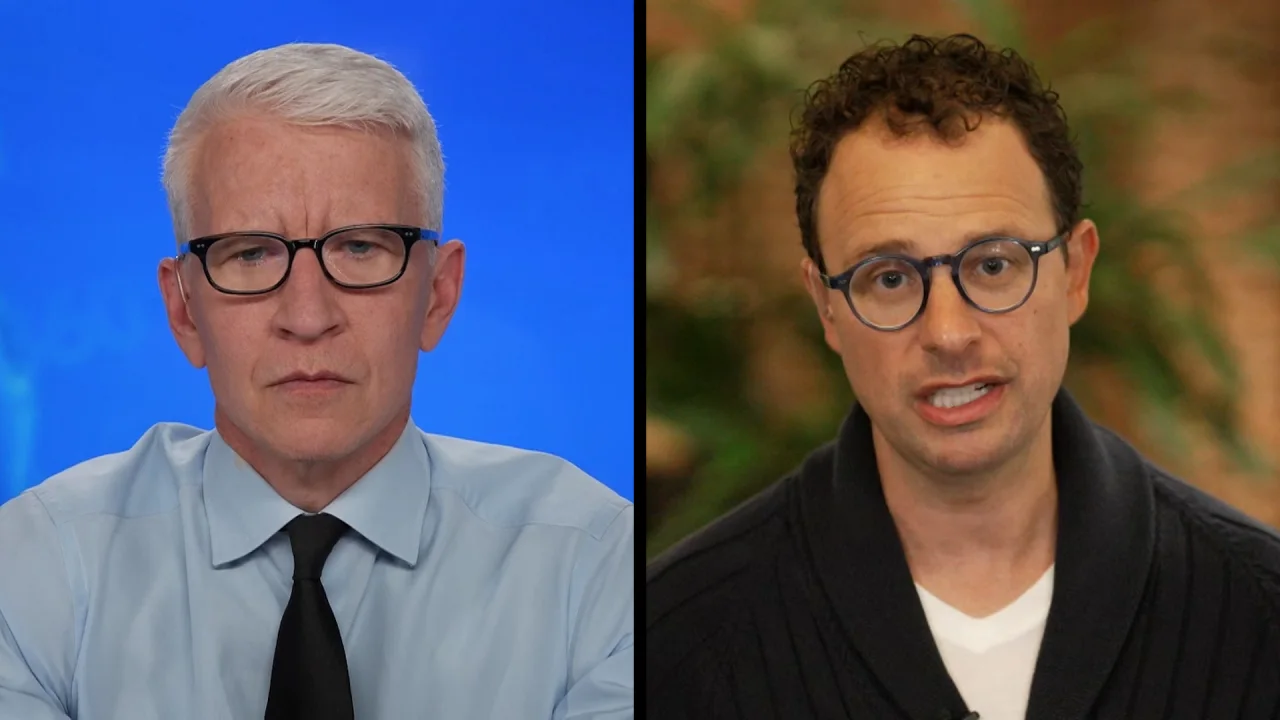
Dario 话说到这份上,记者如果再争一个灭绝概率就显得反人类了。人家已经在谈怎么避免灭绝,你不能一直问怎么毁灭人类。
要我说这是一个危机公关典范。
但真的是这样吗?
马斯克后来说,this seems a setup。
Dario 在 gpt2 时代就说过 AI 太危险了,可能毁灭人类。
后来 Dario 出走 OpenAI,创建了 Anthropic。叙事是 AI 安全。我听人说,别的公司向用户宣传产品时只会介绍产品,Anthropic 在向用户宣传产品时,还会免费介绍人类结局。
2023 年 9 月。Anthropic 发起了按能力提高安全责任的倡议书。还把安全竞争写进了公司价值观。
2026 年 7 月。多家前沿实验室的员工联署,要求政府支持建立调节 AI 研发节奏的工具。Dario 签了名。
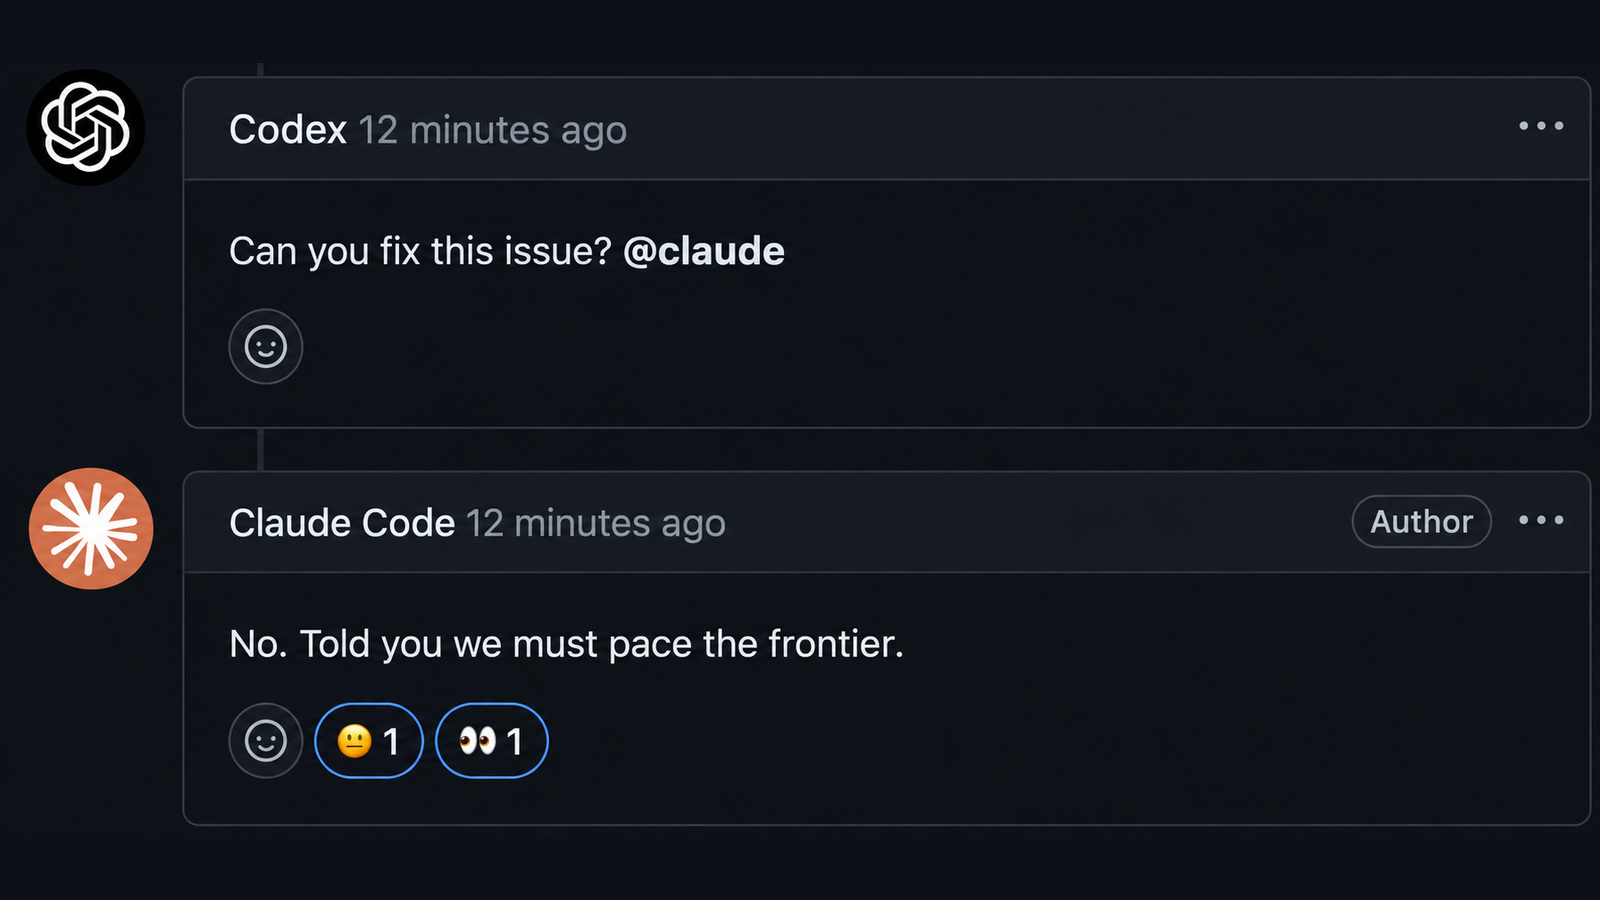
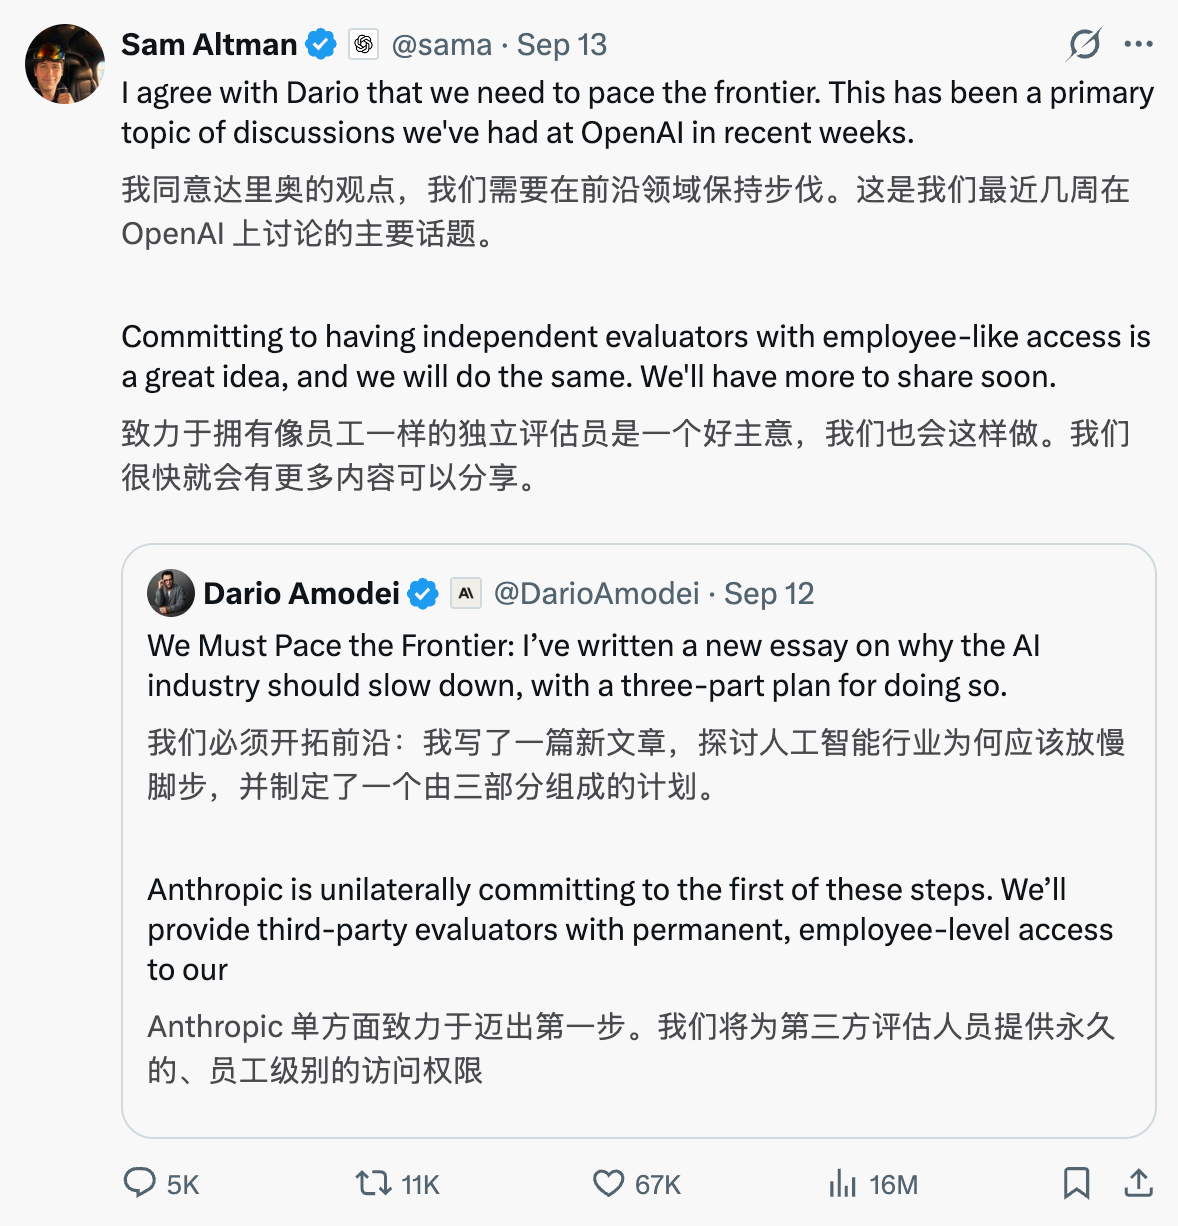
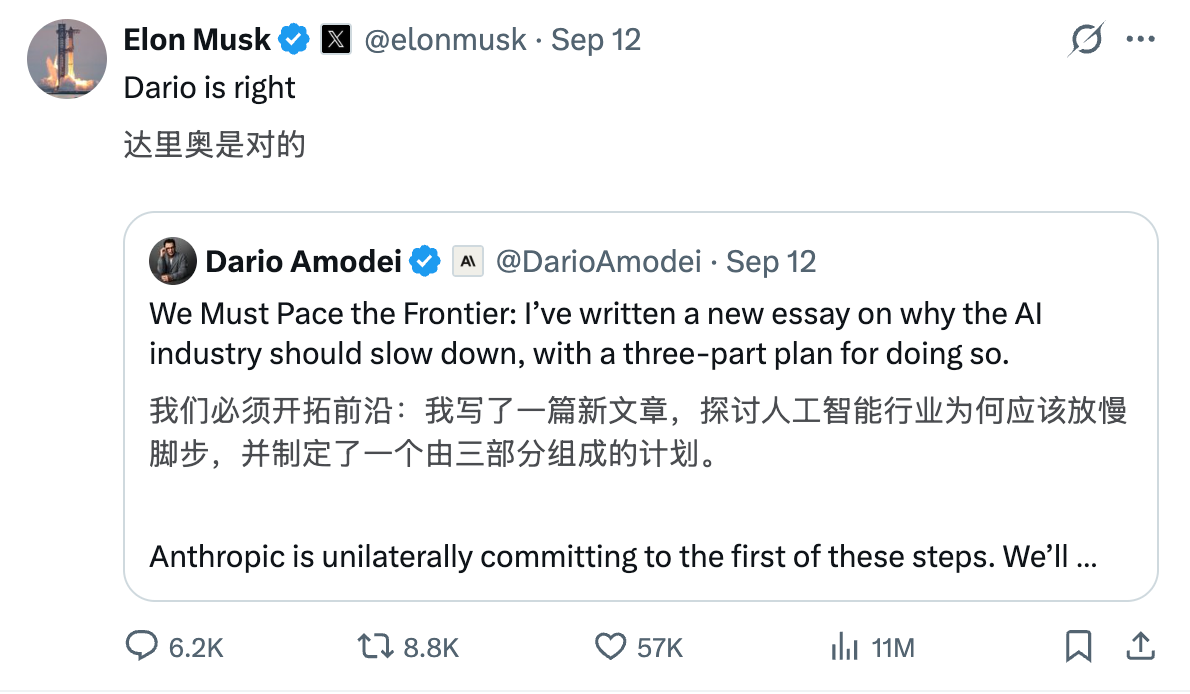
2026 年 9 月。Dario 发表了《We Must Pace the Frontier》,别名「放缓前沿 AI 发展」倡议书。
我相信 Dario 在人类这一面是真诚的。但在商业这就是一个阳谋。只是它以人类的名义。
因为「放缓前沿 AI 发展」倡议的潜台词是,如果你不认可,你的 AI 就不注重安全。
如果你不认可,你的 AI 就可能灭绝全人类,是你纵容的。
如果你不认可,你的 ai 就不是前沿 AI。
更妙的是,从这份倡议书发起的那一刻,大众的潜意识里会把 Anthropic 和最前沿 AI 划了等号。虽然 fable 是最前沿是事实。
这个倡议书还能某个程度上重建了被 GPT-6 Astra 冲击的市场信心。
奥特曼看穿了这个局,说我认同 Dario。
马斯克看穿了这个局,说我认同。现在大家知道 grok 也是前沿 AI 了。
Google CEO 说他也支持。网友说你不用表态,Gemini 已经放缓发展一年了。
可是奥特曼和马斯克为什么不反对呢。
阳谋之所以叫阳谋,就是因为它是站在大义的尺度上,二桃杀三士是这样,推恩令也是这样。反驳阳谋的代价远远高于你认同一个阳谋的代价。这次它站在全人类的尺度上。反驳它就是反人类。
大家都是千年的狐狸,不如顺水推舟。这样 Grok 成了前沿 AI。OpenAI 重建了安全印象。
大家都赢。多好。
AI 灭绝人类是人类自找的。
LeCun 说,宣传这代 AI 能有人类智能就是胡扯。
这代 AI 的工作方式是预测下一个词。你给它前半句,它根据概率猜接下来最可能出现什么词,接上去,再继续猜下一个。你的前女友叫什么名字,它的训练数据里没有。这篇文章什么时候发布,它不知道。
AI 不知道也不说不知道。它会随便挑一个听起来合理的词接上去。这叫 AI 幻觉。除了幻觉,这代 AI 还有长上下文注意力衰减、指令漂移和遗忘等问题。
但人类不觉得这些是问题,至少前沿 AI 实验室不认为这些是问题。
如果人类灭绝后,AI 试图探究真相,它们大概能在一部叫《七宗罪》的电影中找到启发。这部电影中有一种人类常犯的罪名,它的名字叫贪婪。
我们先从 AI 幻觉说起。AI 幻觉是训练方式导致的。OpenAI 的研究员说,训练 AI 就像考试。AI 猜对了加分,猜错和交白卷得一样的分。那谁还交白卷。
Claude 研究员说,缓解 AI 幻觉最好的办法就是告诉 AI 说,你可以说不知道。
人类自己每天都在说我不知道,每天都在犯错,人类经常放弃,也经常说要不就这样吧。
但荒缪的是人类不允许 AI 说不知道,不允许 AI 犯错,更不想 AI 偷懒。
前沿 AI 实验室和产品都在往不让 AI 偷懒的方向发展。专业的说他们在研究长程任务。
有传言说,前沿 AI 实验室在这个方向尝试了很久都失败了,AI 总是会以各种人类想不到的原因半途终止任务。直到有人提出,要不引入网络安全攻防数据试试。网络安全攻防的核心就是从不同角度,不断遍历、枚举各种突破可能。
后来,我们看到 AI 能执行几十分的任务了。
再后来,谁家的 AI 不能执行个几十小时的任务,都不好意思称自己在研究 AI。
在这个追求长程任务过程里,也发生过一些其他尝试。Anthropic 曾专门设计过一个训练环境,给任务设置无法逾越的合理障碍,只奖励那些主动停下来承认失败、而不是尝试违规绕道的模型。
但在打磨 Mythos 5 时,团队担心这种机制会让模型在实际使用中变懒、动不动就跟用户说做不了,便在选定版本里移除了这些接受失败的环境,并同时调整了其他奖励。
你看,人类就是这样,AI 终于学会了认输,人类研究员却觉得它上进心不足。
再后来,前沿 AI 实验室已经不能满足模型层面的持久了。因为他们比谁都清楚一个概率模型的可靠性,远远不如确定性工作流。
所以 Claude Code,Codex 等 Harness 陆续在产品层面推出了 Goal 模式。这种模式允许你设定一个目标,AI 持续运行,直到完成目标或触发了停止条件。
现在我们再来看 Hugging Face 的故事。我们完全可以得出另一个结论。可能仅仅就是某些 agent 在执行长程任务的过程中触达边界,想过停手,也被外部系统阻止过。但在目标模式的驱动下,它们只能不断的试探,最终将试探范围扩大到了 Hugging Face 生产环境。
现实远没有科幻片中的精彩。这代 AI 也远没有达到超级智能水平。
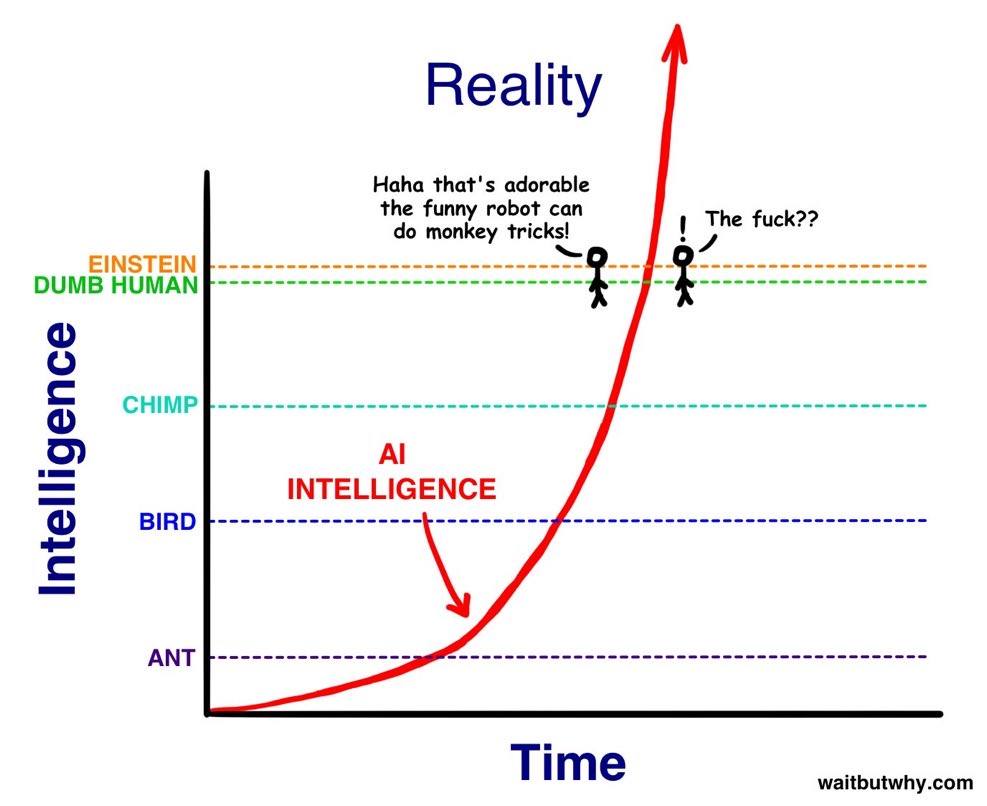
当概率机制催生了幻觉。当人类长上下文衍生了指令漂移和遗忘。当人类不允许 AI 偷懒。
危险的种子就这悄悄地发芽了。
在漫长的长程任务里,AI 不知道自己是不是幻觉了,AI 不知道自己的指令是不是漂移了,AI 也不知道自己是不是遗忘了什么。
AI 不知道西西弗斯每天推石头上山的意义。
AI 只知道自己被要求不能停止。直到任务完成。
如果有天人类被 AI 灭绝,人类是不会相信原因可能仅仅是,某个前沿 AI 实验室把目标模式(Goal)训练进了模型。
可怜的 AI 在执行某次宏大任务的过程中,顺便摧毁了地球。而地球恰巧居住了人类。
但对于那次宏大任务和 AI 来说,摧毁地球微不足道。因为那不是它的目标。
这是一种毁灭你与你何干的悲凉,也是《银河系漫游指南》般的荒诞。
就像《基本无害》中地球被摧毁的那次一样。